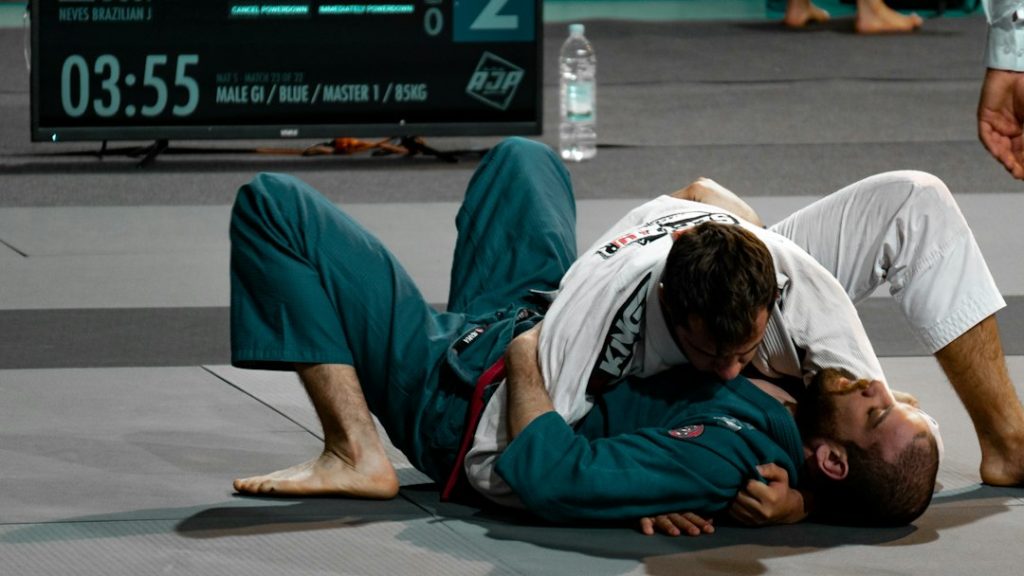
ماذا يحدث عندما تضع ثقتك في نموذج ذكاء اصطناعي، ثم يخيب ظنك أمام ملايين المشاهدين؟ هذا بالضبط ما حدث مع المقاتل بلال حسن بعد خسارته الأولى في مسيرته الاحترافية خلال UFC 334 أمام لويس غورولي، حين وجد نفسه يوجّه عبارة غاضبة ساخرة إلى ChatGPT على الملأ.
المفارقة أن حسن دخل النزال وهو المرشح الأوفر حظاً، وكانت توقعات النموذج اللغوي تصب في مصلحته. لكن الحلبة لا تقرأ التوقعات، وغورولي خرج فائزاً في مفاجأة أعادت طرح سؤال قديم بثوب جديد: إلى أي مدى يمكن الاعتماد على الذكاء الاصطناعي في قراءة ما سيحدث؟
حين تصبح التوقعات مادة للسخرية
لم تكن خسارة بلال حسن حدثاً رياضياً عادياً فقط، بل تحوّلت بسرعة إلى ميم متداول على منصات التواصل. المقاتل البالغ 25 عاماً، والذي ينافس في وزن الذبابة، وجد في ChatGPT كبش فداء جاهزاً لتهكمه، بينما احتفل غورولي بفوزه وردّ بدوره على توقعات الذكاء الاصطناعي التي استبعدته.
هذا السلوك يكشف تحولاً ثقافياً أعمق: النماذج اللغوية لم تعد أدوات في الخلفية، بل أصبحت أطرافاً يُلامون ويُسخر منهم علناً. المستخدم اليوم يتعامل مع ChatGPT كما يتعامل مع خبير أو صديق يقدّم نصيحة، وحين تفشل النصيحة، يأتي اللوم.
لماذا التوقعات الرياضية فخّ مثالي للنماذج اللغوية؟
الرياضة القتالية تحديداً من أصعب المجالات على أي نموذج تنبؤي. النتيجة تعتمد على لحظة واحدة، على ردة فعل عصبية، على إصابة مفاجئة، على قرار حكم. لا شيء من هذا متاح لنموذج لغوي يقرأ بيانات سابقة ويصوغ احتمالاً.
ChatGPT ليس محرك تنبؤات إحصائي متخصص، بل نموذج يولّد نصاً يبدو معقولاً بناءً على أنماط. الفرق بين الأمرين جوهري، لكن المستخدم العادي لا يرى هذا الفرق إلا حين يخسر رهانه.
الفرق بين «يتوقع» و«يخمّن بثقة»
هنا تكمن المشكلة التقنية الحقيقية. النماذج اللغوية الكبيرة مُدرَّبة على إكمال النصوص، لا على حساب الاحتمالات الرياضية. حين يُسأل ChatGPT عن نتيجة نزال، فإنه ينتج إجابة تبدو واثقة، لكن هذه الثقة ليست مؤشراً على الدقة.
هذا ما يسميه الباحثون «الهلوسة الواثقة»: مخرجات سلسة ومقنعة بلا أساس إحصائي متين. في المجال الطبي أو القانوني قد يكون هذا خطيراً، وفي الرياضة قد يكون مضحكاً، لكن المبدأ واحد.
الأنظمة المتخصصة في التنبؤ الرياضي تعتمد على نماذج إحصائية منفصلة، تحلّل سجل المقاتلين، وأسلوب القتال، والتاريخ البدني، وأحياناً بيانات حركية دقيقة. ChatGPT لا يفعل ذلك، ومع ذلك يُسأل كما لو كان يفعل.
المستخدم العربي: بين الثقة العمياء والفضول التقني
في السوق العربي والخليجي، نما استخدام أدوات الذكاء الاصطناعي التوليدي بوتيرة لافتة خلال العامين الماضيين. كثير من المستخدمين يتعاملون مع ChatGPT كمستشار شامل: للدراسة، والعمل، وحتى للتوقعات الرياضية قبل المباريات الكبرى.
هذه الثقة المتنامية تحمل فرصة ومخاطرة في آن. الفرصة أن الوعي التقني يتوسّع، والمخاطرة أن الفجوة بين «ما يبدو ذكياً» و«ما هو دقيق» قد تتسع إن لم تترافق مع ثقافة نقدية.
في أسواق مثل السعودية والإمارات، حيث تتسارع استثمارات البنية التحتية للذكاء الاصطناعي، يصبح تعليم المستخدم حدود الأداة أمراً استراتيجياً لا رفاهياً. الأداة القوية في يد من لا يعرف حدودها قد تنتج قرارات خاطئة بثقة عالية.
درس للمنصات الرياضية العربية
المنصات الإعلامية الرياضية العربية التي بدأت تدمج توقعات الذكاء الاصطناعي في محتواها تحتاج إلى حذر مضاعف. تقديم توقع آلي كأنه حقيقة إحصائية قد يضرّ بالمصداقية حين ينقلب السيناريو.
الأفضل هو تقديم هذه التوقعات كـ«زاوية ترفيهية» لا كتحليل موثوق، مع توضيح المنهجية أو غيابها. الشفافية هنا ليست تفصيلاً تقنياً، بل شرط بقاء للثقة.
ماذا نتعلم من نزال واحد؟
الحادثة، رغم خفتها، تختصر نقاشاً تقنياً كبيراً: النماذج اللغوية أدوات لغوية في جوهرها، لا أوراكل. إسقاطها على مجالات تحتاج يقيناً إحصائياً هو سوء استخدام، لا عيب في الأداة نفسها.
الشركات المطوّرة تدرك هذا وتعمل على طبقات تحقق ومصادر، لكن المستخدم يبقى الحلقة الأضعف إن لم يمتلك الحد الأدنى من الحس النقدي. الوعي هو الطبقة الأمنية الأخيرة.
والأهم: السخرية من ChatGPT بعد خسارة رياضية قد تكون لطيفة، لكن الاعتماد عليه في قرارات مالية أو صحية بلا تحقق هو ما يستدعي القلق الحقيقي.
الخلاصة: الأداة لا تتحمل مسؤولية ثقتك
بلال حسن خسر نزالاً، وChatGPT خسر هيبة زائفة لم تكن له أصلاً. المشكلة ليست في النموذج الذي أخطأ في توقع، بل في الثقافة التي منحته سلطة لم يدّعها.
الذكاء الاصطناعي سيصبح أفضل في التنبؤ، لكنه لن يصبح معصوماً، والمستخدم الذكي هو من يسأل دائماً: ما مصدر هذه الإجابة؟ وما احتمال خطئها؟
السؤال للنقاش: هل تعتقد أن أدوات الذكاء الاصطناعي يجب أن تتوقف عن تقديم توقعات قاطعة في مجالات كالرياضة والمال، أم أن المسؤولية تقع على المستخدم وحده في فهم حدود الأداة؟